



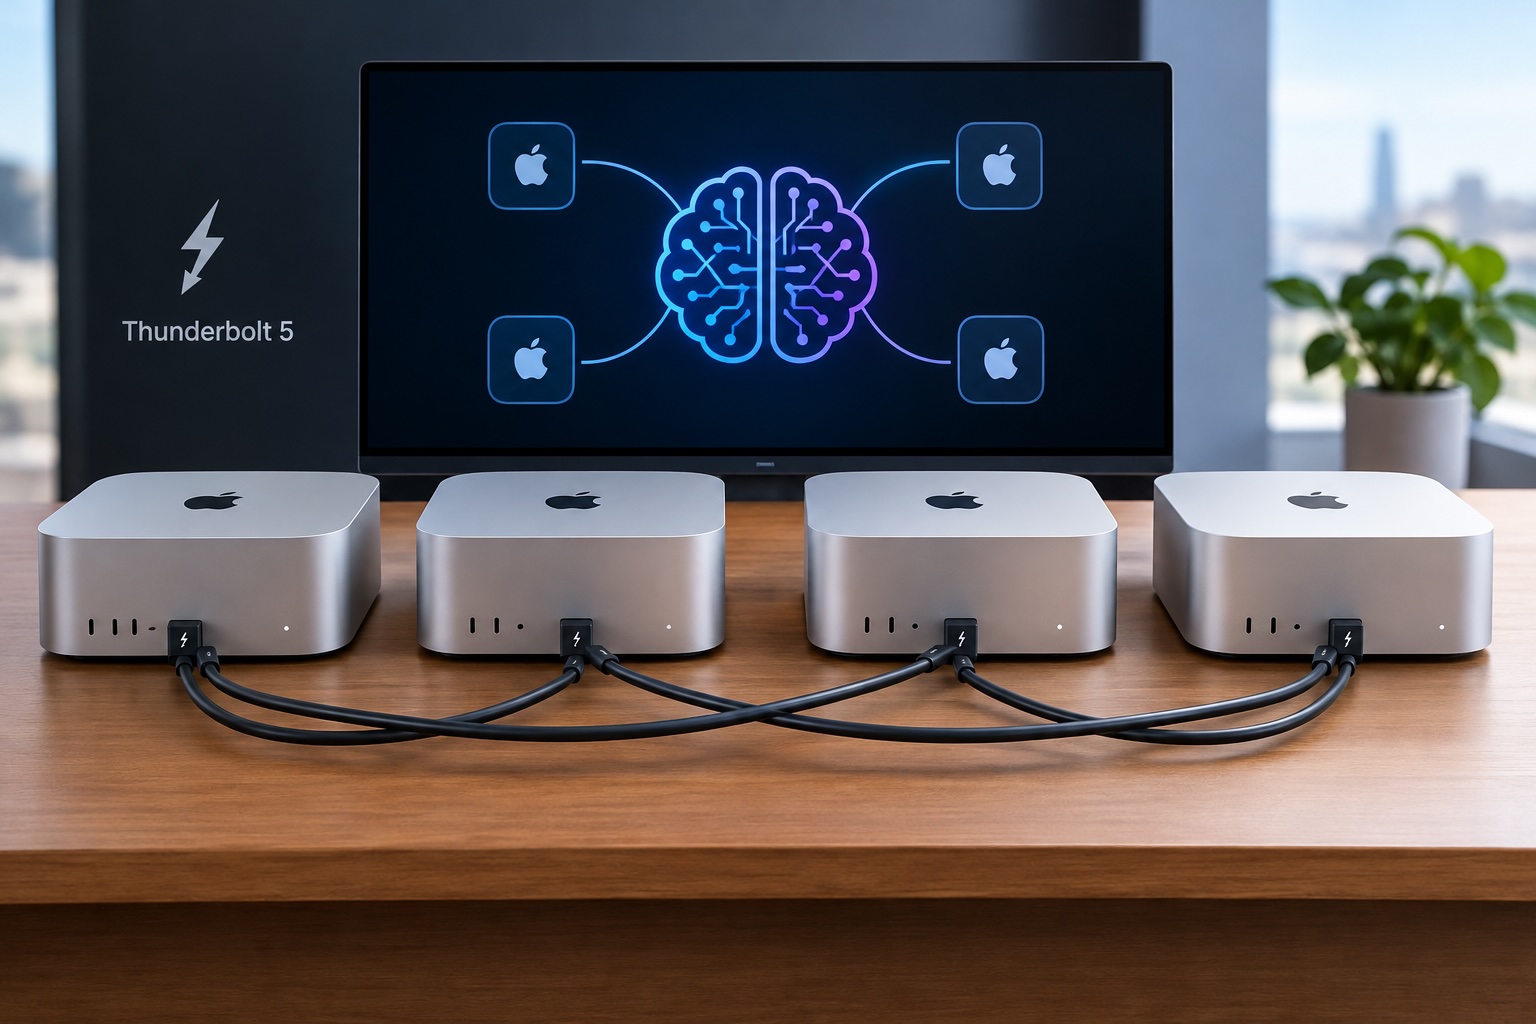
La demo de Apple en la WWDC26 fue difícil de no disfrutar. Cuatro Mac Studios, un puñado de cables Thunderbolt y un modelo de aproximadamente un billón de parámetros respondiendo sobre un escritorio en lugar de hacerlo en un centro de datos. Un día antes de este artículo, el equipo de machine learning de Apple publicó nuevas cifras del mismo montaje.
Es tentador concluir que puedes comprar unas cuantas Mac, conectarlas entre sí y poner a funcionar un servicio de IA privado para tu empresa. La tecnología es real. Pero los reportes públicos de errores cuentan una historia menos pulida, sobre todo en lo que pasa cuando falla una máquina o un cable.
Esta guía explica para qué sirve el clustering de Mac, cómo funciona, qué hace falta para configurarlo y en qué puntos todavía se rompe. Cada afirmación se contrastó con las propias páginas de Apple y con los rastreadores de los proyectos en GitHub, al 16 de octubre de 2026.
En resumen
- Qué es: conectar Mac con chips de Apple mediante Thunderbolt 5 para que puedan ejecutar juntas un modelo de IA grande.
- Qué necesitas: macOS 26.2 o posterior, Mac y cables compatibles con Thunderbolt 5, y una configuración de software seria.
- Qué funciona: juntar la memoria para ejecutar modelos que ninguna Mac puede contener por sí sola, y generar texto más rápido en las pruebas de Apple.
- Qué falta: un comportamiento documentado cuando falla un nodo. Los reportes públicos describen cuelgues y caídas.
¿Para qué sirve esto?
Un modelo de lenguaje de IA tiene que estar en memoria mientras funciona. Mientras más grande es el modelo, más memoria necesita. Según la publicación de investigación de Apple, una sola Mac Studio llega como máximo a 512 GB de memoria unificada. Algunos de los modelos abiertos actuales necesitan mucho más.
En su sesión de la WWDC26, Apple ejecutó Kimi 2.6, un modelo de alrededor de 1 billón de parámetros que ocupa aproximadamente 1 TB en 8 bits, repartido entre cuatro Mac con M3 Ultra. Una sola M3 Ultra no puede contenerlo.
El clustering hace dos cosas:
- Junta la memoria. Los modelos demasiado grandes para una sola máquina pueden ejecutarse repartidos entre varias.
- Puede aportar velocidad. Apple reportó casi 3 veces la tasa de tokens de una sola M3 Ultra para un modelo de 27 mil millones de parámetros en cuatro Mac.
Piénsalo como cuatro personas cargando un sofá pesado. Juntas pueden levantar lo que una sola no podría, pero solo si no dejan de hablar: «levanten», «giren», «alto». Si una de repente lo suelta, todas tienen un problema. En un clúster de Mac, esa conversación constante va por los cables Thunderbolt.
Cómo funciona
La arquitectura de Apple tiene tres capas, según se describe en la sesión de la WWDC26:
- RDMA sobre Thunderbolt 5. RDMA (acceso remoto directo a memoria) mueve datos de la memoria de una Mac a la de otra con muy poca intervención de la CPU y el sistema operativo. Eso mantiene baja la latencia. La nota técnica TN3205 de Apple indica que está disponible desde macOS 26.2 en Mac con chips de Apple y Thunderbolt 5.
- JACCL. Una biblioteca de código abierto de Apple para la comunicación en grupo entre máquinas, por ejemplo para sumar los resultados parciales de cada nodo.
- MLX y MLX LM. El framework de machine learning de Apple y sus herramientas para modelos de lenguaje. Usan JACCL para repartir un modelo entre varias máquinas.
Hay dos formas principales de repartir un modelo:
- El paralelismo de tensores parte cada capa en pedazos, uno por Mac. Es más rápido por token, pero las Mac se comunican en cada capa, así que la baja latencia es imprescindible.
- El paralelismo de pipeline le da a cada Mac un bloque de capas, como una línea de montaje. Es más liviano para la red, pero no hace que cada token sea más rápido. Apple señala que no todos los modelos lo admiten.
También existe exo, un proyecto de código abierto que se apoya sobre esta arquitectura y agrega descubrimiento automático de dispositivos y planificación. Tiene el mismo requisito: macOS Tahoe 26.2 o posterior.
Conectar los cables no basta
Esta es la parte por la que las demos pasan rápido. Con base en la nota técnica de Apple, la sesión de la WWDC26 y el README de exo, esto es lo que requiere una configuración funcional.
1. El hardware y el cableado correctos
- Mac con chips de Apple y Thunderbolt 5, y cables compatibles con Thunderbolt 5.
- Para lograr la menor latencia, conecta cada Mac con todas las demás (una «malla completa»). Tres Mac necesitan tres cables; cuatro Mac necesitan seis.
- Los puertos se agotan rápido. La nota de Apple muestra cinco Mac conectadas en anillo, donde el software tiene que reenviar los datos a través de los vecinos, porque RDMA sobre Thunderbolt no puede enrutar el tráfico por sí mismo.
- El README de exo indica que el puerto Thunderbolt 5 que está junto al puerto Ethernet de una Mac Studio no se puede usar.
2. Software idéntico en todas partes
- exo exige versiones de macOS exactamente iguales en todos los dispositivos, hasta el número de compilación beta.
- Apple indica que cada Mac necesita MLX y el programa que vas a ejecutar, en la misma ruta en cada máquina, además de acceso SSH entre ellas.
3. RDMA activado
La nota técnica de Apple describe cómo activar RDMA desde la Recuperación de macOS:
# En la Recuperación de macOS: Utilidades → Terminal
rdma_ctl enable
# luego reinicia en macOS
La sesión de la WWDC26 muestra otra ruta: buscar «RDMA» en Configuración del Sistema, activar «Habilitar RDMA sobre Thunderbolt» y reiniciar. Cuál veas puede depender de tu versión de macOS, así que revísalo en tus propias máquinas.
Luego confirma que los enlaces estén activos:
ibv_devices    # lista las interfaces RDMA, como rdma_en2
ibv_devinfo    # cada puerto conectado debería mostrar PORT_ACTIVE
Un puerto solo se activa cuando las Mac de ambos extremos tienen RDMA habilitado.
4. Ajustes de red y energía
- Desactiva el Puente Thunderbolt (Configuración del Sistema → Red → Puente Thunderbolt → Desactivar). Apple advierte que, con cables formando bucles, el puente puede reenviar tráfico sin parar y desperdiciar CPU.
- Desactiva la suspensión por inactividad. Thunderbolt no admite Wake-on-LAN, así que una Mac suspendida se sale del clúster.
- Activa el inicio de sesión automático y «Iniciar automáticamente después de un corte de energía», para que el clúster pueda volver sin que nadie esté frente al teclado.
5. Configurar y lanzar
MLX incluye un asistente que verifica SSH, detecta cómo están cableadas las Mac y escribe un archivo de hosts. Con --auto-setup también desactiva el Puente Thunderbolt y configura cada enlace. Sin esa opción, imprime los comandos para que los revises. Esto viene de la sesión de la WWDC26, con nombres de host de ejemplo:
mlx.distributed_config
    --hosts mac-0,mac-1,mac-2,mac-3
    --output "cluster-jaccl.json"
    --env MLX_METAL_FAST_SYNCH=1
    --auto-setup
    --backend jaccl

mlx.launch --hostfile "cluster-jaccl.json" --
    /remote/path/to/mlx_lm.chat --model "<model-name>" --max-tokens 2048
Para ofrecer el modelo a otras apps mediante una API, la publicación de investigación de Apple ejecuta mlx_lm.server --port 8080 bajo mlx.launch.
Lo que Apple mostró y lo que no dijo
La publicación de investigación de Apple del 15 de octubre de 2026 reporta que Muse Spark Open, un modelo de 816 mil millones de parámetros con 42 mil millones activos, generó más de 36 tokens por segundo en cuatro Mac Studio con M5 Ultra, con un contexto de 8192 tokens. La letra pequeña importa:
- El modelo se evaluó en 4 bits NVFP4, no en precisión completa BF16, y la publicación no reporta la calidad de las salidas.
- Las pruebas usaron un tamaño de lote de 1 y 128 tokens generados. Eso es un usuario a la vez, no un equipo.
- Apple describe el ajuste
MLX_METAL_FAST_SYNCH=1usado en sus comandos de lanzamiento como una función experimental de MLX.
Lo que falta es igual de revelador. Ni la transcripción de la sesión de la WWDC26 ni la publicación de investigación usan las palabras «producción» o «estable». Apple no promete que esté listo para producción. Tampoco explica qué pasa cuando algo falla. La sensación de que es un producto terminado viene de lo fluido que se ven las demos.
Lo que muestran los rastreadores de errores
Los reportes de abajo vienen de usuarios individuales en los proyectos de código abierto MLX y exo. No nos dicen con qué frecuencia ocurren los problemas, y algunos podrían cambiar con nuevas versiones. Pero describen fallas concretas en hardware real.
| Reporte | Qué describe | Estado al 16 oct. 2026 |
|---|---|---|
| MLX #3910 | Cuando un par desaparece a mitad de una operación, JACCL espera para siempre: sin error, sin tiempo de espera. Probado en cuatro Mac con M3 Ultra. | Abierto |
| MLX #4192 | Desconectar un cable Thunderbolt a mitad de una operación hace que los procesos de ambos extremos se caigan. | Abierto |
| MLX #3162 | Un límite medido por un usuario de unas 100 regiones de memoria por dispositivo podría restringir la escalabilidad a más Mac. | Abierto |
| exo #1843 | exo 1.0.69 en macOS 26.4 se caía repetidamente al arrancar en una sola Mac, sin otros dispositivos. | Abierto |
| MLX #4485 | JACCL se caía al arrancar en un montaje de dos Mac. Quien lo reportó usaba una bifurcación de desarrollo. | Cerrado el 1 oct. 2026 |
Una corrección propuesta para detectar pares caídos, el pull request #4530 de MLX, agrega verificaciones de salud y un tiempo de espera configurable (600 segundos por defecto). Se cerró sin fusionarse. La propia nota técnica de Apple también enumera límites estrictos, entre ellos un máximo de 10 conexiones («pares de colas») por dispositivo.
¿Qué pasa cuando falla un nodo?
Esta es la pregunta que un servicio de empresa tiene que responder, y los reportes no son muy tranquilizadores:
- El trabajo puede colgarse en silencio. En el #3910, todas las máquinas se congelaron tras jalar un cable. Volver a conectarlo un minuto después no recuperó nada. Solo reiniciar el trabajo lo logró.
- Puede ser difícil de detener. El mismo reporte dice que una señal normal de apagado fue ignorada, así que solo funcionó forzar la terminación, lo que en macOS puede dejar memoria bloqueada hasta un reinicio.
- Puede fallar sin ningún disparador. El mismo usuario vio un segundo cuelgue tras unas 75 horas de servicio sin causa identificada. En el #4192, un usuario con cinco Mac M3 Ultra reportó dos caídas en producción donde los enlaces se cayeron solos. La máquina caída mantuvo unos 140 GB de memoria bloqueada, y su puerto quedó inactivo hasta el reinicio.
- El enlace tiene pocas garantías integradas. La nota de Apple explica que un envío completado no confirma que los datos llegaron intactos, porque Thunderbolt no acusa recibo de la entrega por hardware. Las conexiones son de un tipo «no confiable», así que detectar problemas queda en manos del software.
En las fuentes que revisé no encontré ningún mecanismo de conmutación por error documentado. Si una Mac se cae, todo el trabajo parece detenerse o colgarse con ella.
Entonces, ¿está listo para producción?
Esta sección es mi opinión editorial, basada en la evidencia de arriba.
Para investigación, desarrollo, experimentos privados o una demo, el clustering de Mac es real, capaz y vale la pena explorarlo. Para un servicio siempre encendido del que dependen tus colegas, los reportes abiertos sobre cuelgues, caídas y recuperación manual son una falla seria, y nada de lo que encontré demuestra que se hayan resuelto.
Si aun así quieres construir sobre esto, algunas precauciones tienen sentido:
- Congela las versiones. Fija versiones exactas de macOS y MLX y actualiza solo después de probar.
- Rómpelo a propósito. Jala un cable, apaga un nodo y observa qué pasa antes de que se den cuenta tus usuarios.
- Automatiza la recuperación. Pon un «perro guardián» (watchdog) alrededor del trabajo que pueda detectar un cuelgue y reiniciarlo.
- Ten un plan B. Un modelo más pequeño en una sola Mac puede mantener vivo el servicio mientras el clúster se reinicia.
- Vuelve a revisar los rastreadores. Puede que los problemas de arriba ya estén resueltos para cuando leas esto.
Conclusiones clave
- El clustering con Thunderbolt 5 permite que las Mac junten su memoria y ejecuten modelos que ninguna sola Mac puede contener, a partir de macOS 26.2.
- La configuración requiere más que cables: RDMA habilitado en cada Mac, versiones de software idénticas, una malla completa o un anillo planificado, el Puente Thunderbolt apagado y la suspensión desactivada.
- Las cifras publicadas por Apple son pruebas de un solo usuario con un modelo de 4 bits, y Apple no afirma que esté listo para producción.
- Los reportes públicos describen cuelgues silenciosos y caídas cuando falla un enlace o un nodo, sin ningún mecanismo de conmutación por error documentado.
- Hoy es una herramienta de laboratorio excelente. Pon a prueba a fondo los escenarios de falla antes de prometerle a alguien un servicio confiable.
Fuentes
- Apple Machine Learning Research — Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio
- Apple Developer — Explore distributed inference and training with MLX (WWDC26)
- Apple Developer — TN3205: Low-latency communication with RDMA over Thunderbolt
- GitHub (ml-explore/mlx) — JACCL MeshImpl::recv spins forever on peer loss — silent hang, no timeout (#3910)
- GitHub (ml-explore/mlx) — JACCL segfaults in tbt_post_recv when a Thunderbolt cable is unplugged mid-collective (#4192)
- GitHub (ml-explore/mlx) — Hardware Bottleneck: AppleThunderboltRDMA hard limit of 100 MRs caps JACCL multi-node scaling (#3162)
- GitHub (ml-explore/mlx) — JACCL segfaults in mx.distributed.init(backend="jaccl") on 2-node Mac-Mac (#4485)
- GitHub (ml-explore/mlx) — Report a dead peer in JACCL instead of spinning forever (PR #4530)
- GitHub (exo-explore/exo) — Crash loop on startup: EXO's own virtual Thunderbolt interfaces trigger false peer detection (#1843)
- GitHub (exo-explore/exo) — exo: Run frontier AI locally (README)